概述
本文介绍如何检查 kubeadm 集群的 etcd、控制平面实例和稳定 API 入口。命令应在与集群版本匹配的
kubectl、etcdctl环境中执行;不同 Kubernetes/etcd 版本的参数可能变化。
etcd 高可用性检查
在使用 kubeadm 安装的 stacked etcd 集群中,每个控制平面节点通常运行一个 etcd 实例。只有成员数量和在线节点仍满足 Raft 多数派时,etcd 才具备持续读写能力;“有多个副本”本身不等于当前一定高可用。
配置 etcdctl 环境变量
登录到任意一个控制平面节点设置临时环境变量。不要把证书路径永久写入所有用户的 /etc/profile:
export ETCDCTL_API=3
export ETCDCTL_CACERT=/etc/kubernetes/pki/etcd/ca.crt
export ETCDCTL_CERT=/etc/kubernetes/pki/etcd/healthcheck-client.crt
export ETCDCTL_KEY=/etc/kubernetes/pki/etcd/healthcheck-client.key
export ETCDCTL_ENDPOINTS=https://192.0.2.1.11:2379,https://192.0.2.1.12:2379,https://192.0.2.1.13:2379
将示例地址替换为实际 etcd 成员地址。若 etcdctl 只在容器镜像内,应使用静态 Pod 对应镜像或安装与服务端主版本兼容的客户端。
检查 etcd 成员状态
使用 etcdctl 工具检查 etcd 集群的成员状态:
etcdctl member list --write-out=table
etcdctl endpoint status --cluster --write-out=table
提示
stacked etcd 拓扑中通常能看到多个成员,每个成员对应一个控制平面节点;external etcd 的成员则位于独立节点。

检查集群健康状态
使用以下命令检查 etcd 集群的健康状态:
etcdctl endpoint health --cluster如果集群健康,输出应该显示所有成员都是健康的。

查询 etcd 的内容
查询 Deployment 信息
etcdctl get /registry/deployments/<namespace>/<deployment-name>注意
由于存入的 Deployment 数据都是做了 protobuf 序列化的,所以看起来格式都不是很正常。
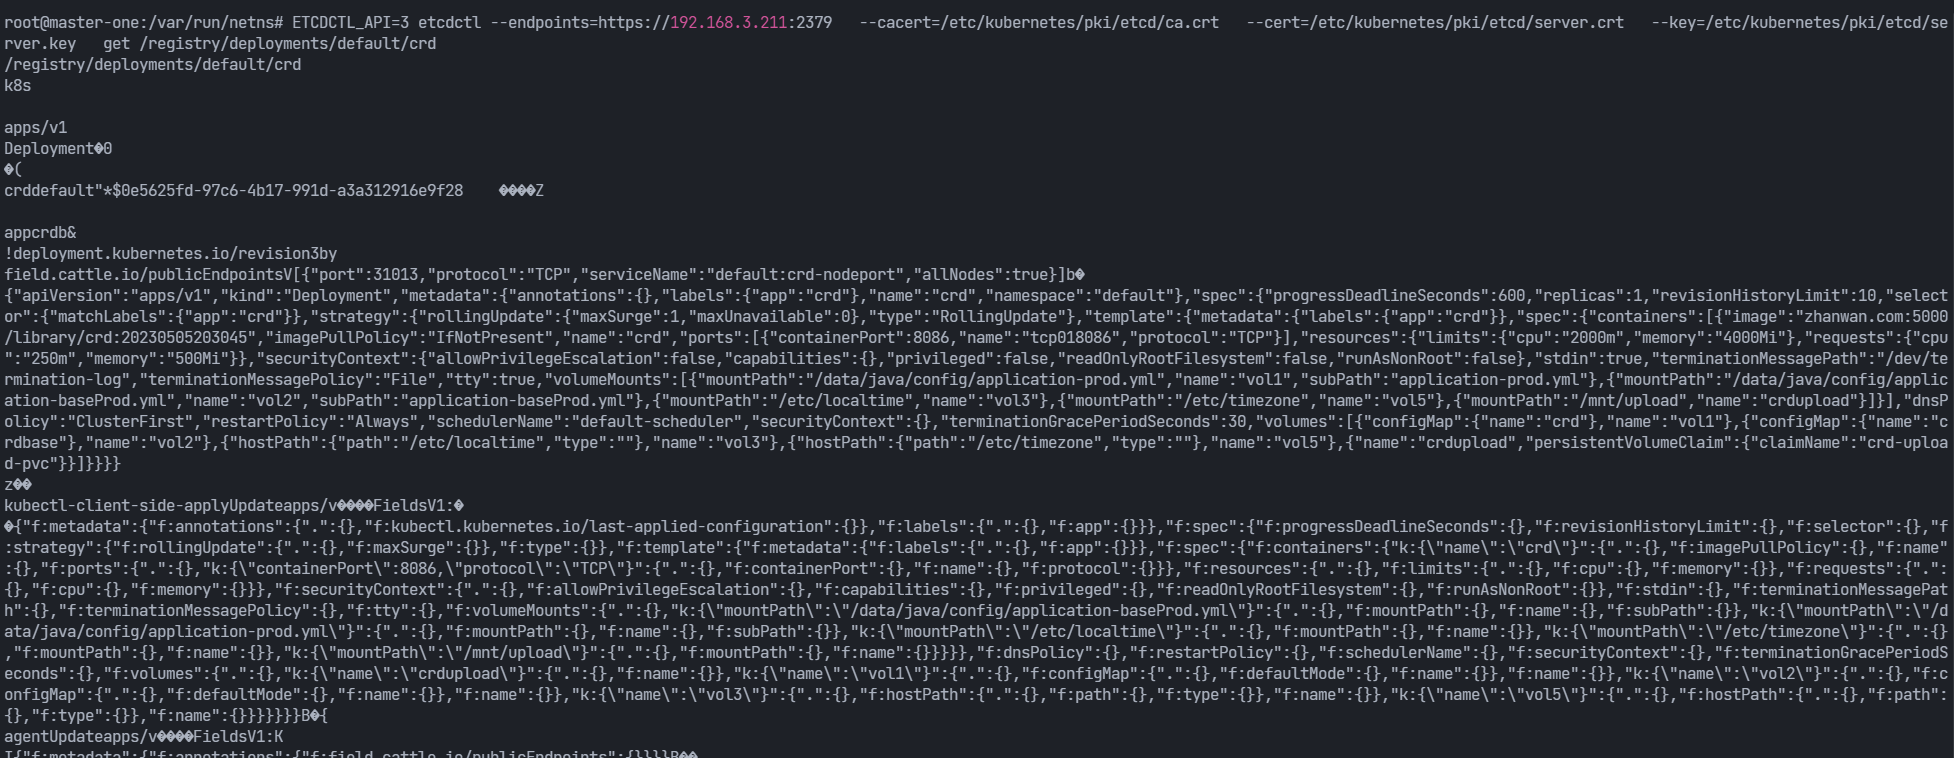
加入 --write-out=json 可以把 etcd 响应元数据包装成 JSON,便于脚本处理,但不会反序列化 Kubernetes 对象:
etcdctl get /registry/deployments/<namespace>/<deployment-name> --write-out=json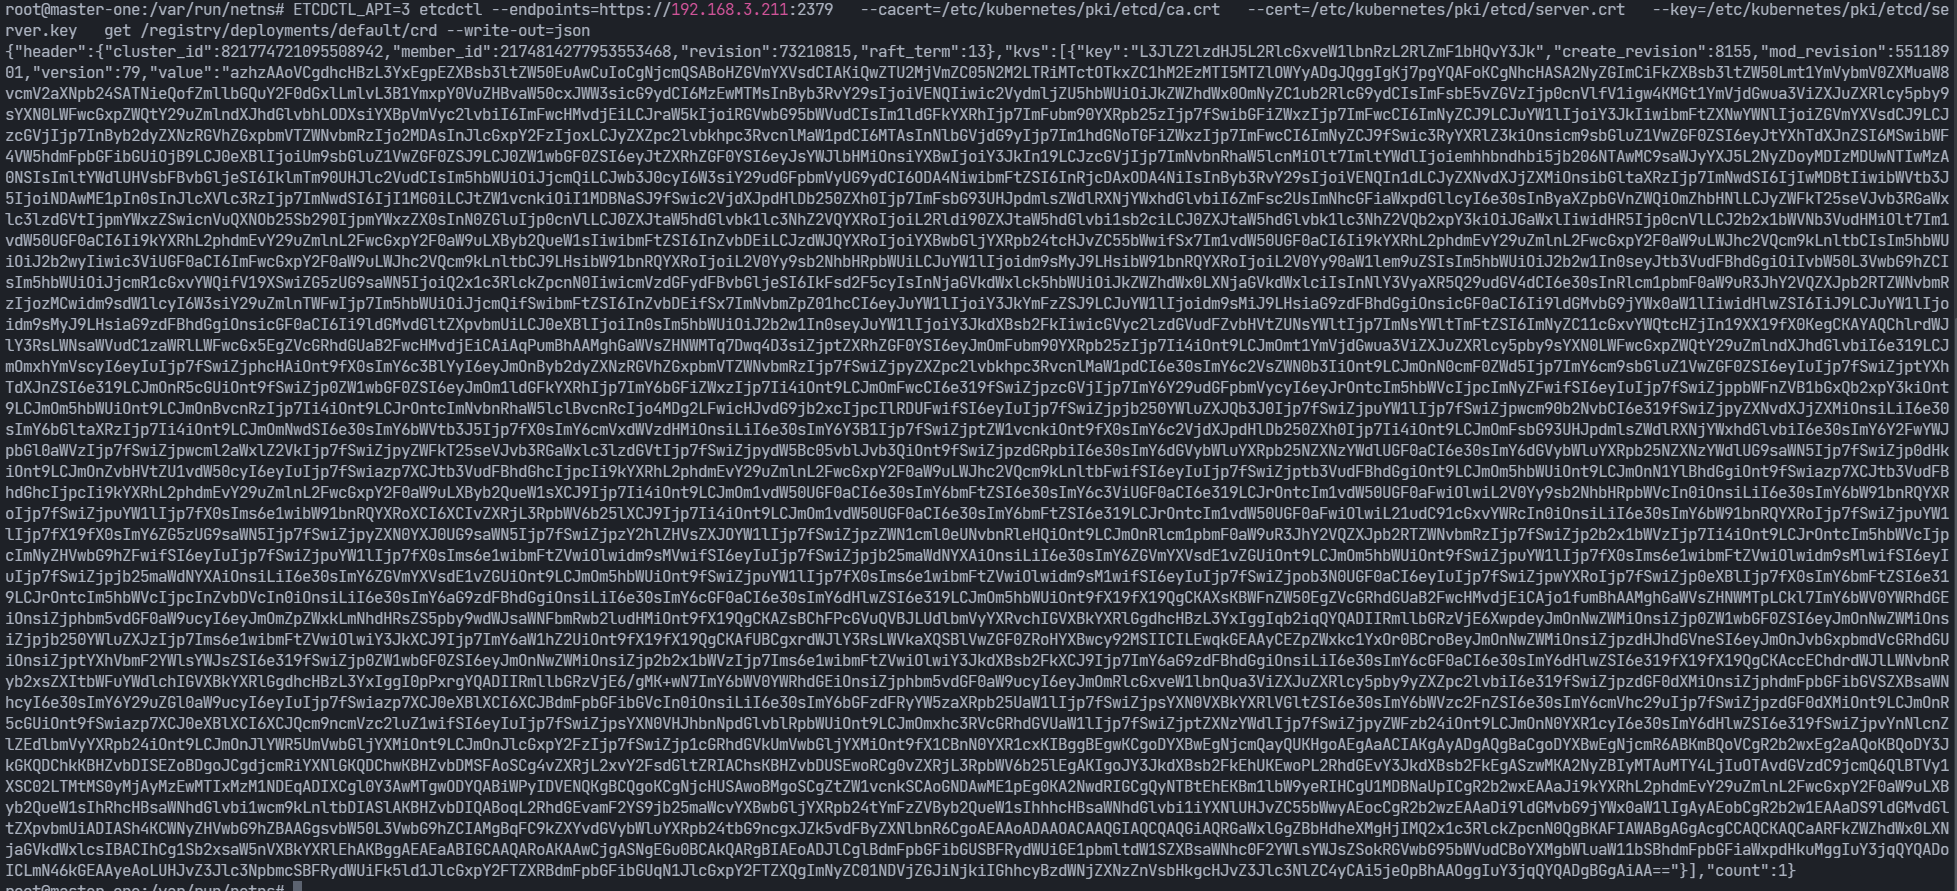
查询 ConfigMap 内容
etcdctl get /registry/configmaps/<namespace>/<configmap-name> --write-out=json说明
--write-out=json输出的是 etcd KV 元数据,value仍是 Base64 包装的 Kubernetes protobuf 数据,并不会自动转换成可读的资源 JSON。验证一致性应以endpoint status --cluster、Raft index 和真实 API 查询为主,不要只比较单个 key 是否存在。
Kubernetes 集群高可用性检查
检查 API 服务器状态
检查当前 kubeconfig 指向的 API Server 是否就绪:
kubectl get --raw='/readyz?verbose'kubectl get componentstatuses 已弃用,而且不能证明所有控制平面节点健康,不再作为检查依据。
检查控制平面组件
检查控制平面组件(如 kube-apiserver、kube-controller-manager、kube-scheduler)是否在所有控制平面节点上运行:
kubectl get pods -n kube-system -o wide你应该看到 kube-apiserver 静态 Pod 分布在不同控制平面节点。kube-controller-manager 和 kube-scheduler 通常也有多个实例,但通过 leader election 只有一个实例处于领导状态;“Pod 为 Running”仍需结合日志、Lease 和 API readyz 判断。
检查工作节点状态
使用以下命令检查所有工作节点(Node)的状态:
kubectl get nodes所有工作节点都应该处于 Ready 状态。
如何更新 kubeconfig 文件
在 Kubernetes 集群中,/etc/kubernetes/admin.conf 文件是用于配置 kubectl 命令行工具的 kubeconfig 文件。这个文件包含了访问集群的必要信息,如 API 服务器的地址、客户端证书、私钥和 CA 证书等。
重要
高可用 kubeadm 集群的 kubeconfig 应指向
controlPlaneEndpoint对应的负载均衡地址或 VIP,而不是第一个控制平面节点的固定 IP。如果所有 kubeconfig 都指向单节点 IP,该节点故障时客户端、kubelet 或控制器可能失去 API 入口。
确保高可用的关键措施
如果某个控制平面节点发生故障,集群仍要保持服务,需要同时满足 API Server 入口可达、etcd 保持多数派以及其余控制器能够完成领导者选举:
- 稳定控制平面入口:使用外部负载均衡器,或独立于 Kubernetes 数据面的 HAProxy + Keepalived/VIP
- 健康检查:负载均衡器应探测每个 kube-apiserver 的 TCP 6443 或 HTTPS
/readyz - 统一 kubeconfig:所有客户端和节点组件指向同一个
controlPlaneEndpoint - 控制平面组件:确保 kube-controller-manager 和 kube-scheduler 等控制平面组件能够在多个 Master 节点之间进行故障转移
- etcd 集群:确保 etcd 集群是高可用的,并且所有 Master 节点都能够与 etcd 集群通信
验证 kubeconfig 切换
实际验证时发现,如果将 config 文件直接从 211 改成 214 也是可以正常工作的:
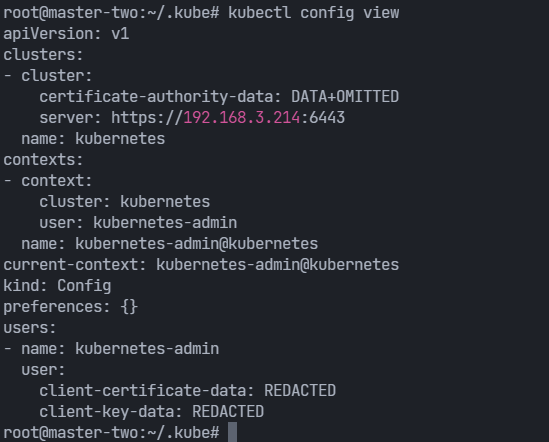
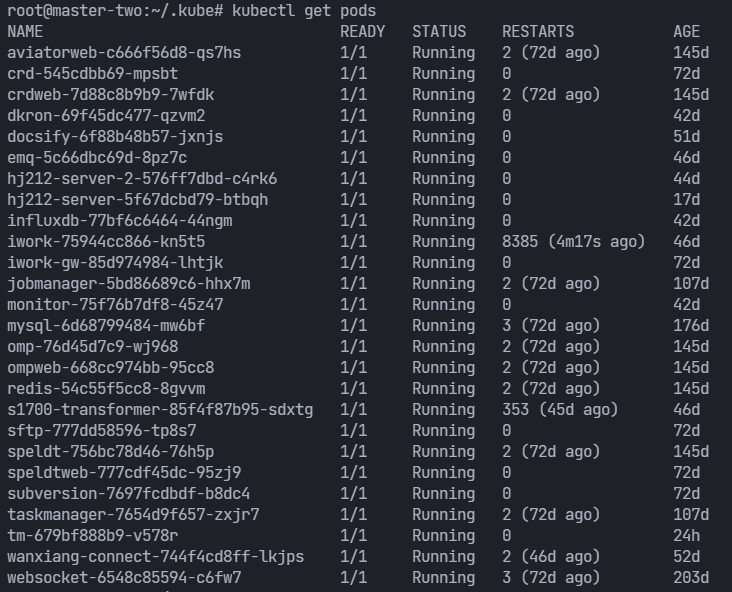
执行 get pods 发现也可以查询到 pod 信息:
不使用外部负载均衡的缺点
潜在问题
如果没有稳定的负载均衡入口,控制平面节点异常时手动修改 kubeconfig 只能临时恢复部分客户端,不能视为高可用方案:
- 手动干预:每次控制平面节点发生故障时,都需要手动更新 kubeconfig 文件
- 高可用性问题:如果集群没有配置为高可用,控制平面没有冗余
- 网络配置:kubelet、kube-proxy 等组件也需要更新以指向新的 Master 节点
- 自动化和弹性:手动更新不支持自动化和弹性
- 恢复不完整:证书 SAN、kubelet、控制器和新节点加入流程可能仍引用旧地址
替代方案
| 方案 | 说明 |
|---|---|
| 外部负载均衡器 | 推荐方案;独立提供健康检查和稳定的 controlPlaneEndpoint |
| HAProxy + Keepalived | 可部署在专用节点或控制平面节点,但必须保证 VIP 组件不依赖 kube-apiserver 才能启动 |
| 云负载均衡器 | 托管环境常用方案,后端为所有 kube-apiserver 实例 |
| DNS 轮询 | 只有 DNS 记录且没有健康检查时不能保证快速摘除故障节点,不应单独作为高可用方案 |
检查稳定控制平面入口
kube-proxy 不是控制平面负载均衡器
kube-proxy 的 iptables/IPVS 规则负责 Kubernetes Service 数据面。即使
default/kubernetesService 能访问 API Server,也不能替代 kubeadm 的controlPlaneEndpoint:kubelet 启动、节点加入和集群外客户端都需要在 Service 网络不可用时访问稳定入口。
1. 查看 kubeconfig 的入口
kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}{"\n"}'
grep -R 'server:' /etc/kubernetes/*.conf
所有关键 kubeconfig 应指向同一个负载均衡域名或 VIP,而不是某一台控制平面节点 IP。
2. 查看 kubeadm 配置
kubectl -n kube-system get configmap kubeadm-config \
  -o jsonpath='{.data.ClusterConfiguration}' | grep controlPlaneEndpoint
3. 验证负载均衡后端
根据实际方案检查 HAProxy、Keepalived、云负载均衡器或硬件负载均衡器。至少执行:
curl --cacert /etc/kubernetes/pki/ca.crt https://<control-plane-endpoint>:6443/readyz随后逐台停止或隔离一个 kube-apiserver 后端,确认入口仍能完成 /readyz 和普通 kubectl get 请求,再恢复节点。故障演练必须在维护窗口执行,并确保 etcd 仍保持多数派。
检查外部负载均衡器配置
如果你的集群配置了外部负载均衡器来分发 API 服务器的流量,确保负载均衡器正确地将流量分发到所有 Master 节点。这通常涉及到查看负载均衡器的管理界面或配置文件,以确保所有 Master 节点都被正确地添加到了负载均衡池中。
注意事项
- 确保你有足够的权限来执行上述检查
- kubeadm 的负载均衡器用于 kube-apiserver,不用于代理 etcd 客户端流量;stacked etcd 依靠 Raft 多数派工作
- 在执行任何检查之前,确保你的 etcd 客户端工具(如 etcdctl)与你的 etcd 集群版本兼容
返回: Kubernetes
相关文档: