B树:为什么每个数据库都在使用它
核心要点:理解让数据库在磁盘上高效运行的数据结构
📋 目录
前言故事
三年前,凌晨3点,我正在研读Alex Petrov的《Database Internals》第2章。
这一章解释了为什么二叉搜索树在磁盘上会失败,为什么低扇出会扼杀性能,为什么B树能够胜出。我想:“我要用Python实现它来真正理解它。”
16,777,215 个条目后,我的树崩溃了。2^24 - 1。右子指针被覆写,整个树都损坏了。每次都是这样。
我只差一次提交就要删除所有代码,改用哈希表了。
然后,更多是出于不服气而非希望,我打开了InnoDB的源代码。MySQL,支撑半个互联网的数据库。如果他们能让B树工作,我也能。
storage/innobase/btr/btr0cur.cc
一条注释跳入我的眼帘:
“btr_page_split_and_insert() in btr_cur_pessimistic_insert() invokes…” btr_page_split… code
悲观插入(Pessimistic insert)。这是当节点太满时的代码路径。当乐观插入失败时。当你必须分裂时。
我跟踪函数到 btr0btr.cc。数百行C代码。分裂条件。溢出保护。还有——一个我没有的差一检查(off-by-one check)。
我滚动查看我的Python代码:
if len(node.keys) >= self.order: # 没有 -1。该死。
self._split_child(parent, index)书中警告过这一点。第263页:“如果节点可以容纳最多N个键值对,插入一个会使其超过最大容量N。”
超过。不是等于。是超过。
就在那里。MySQL开发人员多年前就修复的完全相同的bug。我在不知情的情况下复现了它。
那一刻,我理解了为什么每个严肃的数据库50年来都依赖B+树——并且从未在基于磁盘的索引中使用过其他任何东西。
这就是我脑海中那次点击的故事。
问题场景
你的数据库有1000万条用户记录。你通过ID查询一个用户。数据库在3毫秒内返回结果。如何做到的?
如果数据库顺序扫描所有1000万条记录,需要几秒钟,甚至几分钟。但数据库不扫描。它们使用索引——而那个索引几乎肯定是B树。
每个主要数据库系统都使用B树:
- MySQL InnoDB
- PostgreSQL
- SQLite
- MongoDB的WiredTiger存储引擎
- Oracle Database
- Microsoft SQL Server
这不是巧合。B树解决了一个基本问题:当磁盘访问比内存访问慢数千倍时,如何在磁盘上高效查找数据。
问题:二叉搜索树在磁盘上的失败
让我们从不起作用的开始:磁盘上的二叉搜索树(BST)。
内存中的BST表现优秀
在内存中,二叉搜索树非常出色:
- 每个节点存储一个键,有两个子节点(左和右)
- 左子树的键更小,右子树的键更大
- 查找一个键需要 O(log₂ n) 次比较
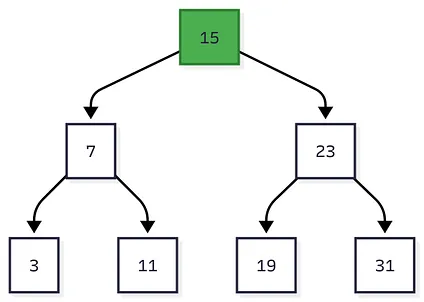
图1:具有7个节点的二叉搜索树。查找键11需要3次比较:15 → 7 → 11
性能分析(100万条记录):
- 平衡BST高度:log₂(1,000,000) ≈ 20
- 内存中:每次比较 ~0.0001 ms,总查找时间 0.002 ms ✅
- 磁盘上:每次比较需要磁盘寻道,总时间 200 ms(HDD)❌
磁盘I/O代价高昂
| 存储类型 | 访问延迟 | 相对速度 |
|---|---|---|
| L1缓存 | 0.5 ns | 基准 |
| RAM | 100 ns | 200x |
| SSD | 0.1 ms | 200,000x |
| HDD | 10 ms | 20,000,000x |
磁盘比RAM慢100-100,000倍。
二叉树灾难
磁盘访问的最小单位是块(通常4KB-16KB)。要从磁盘读取单个字节,必须读取包含它的整个块。
对于磁盘上的BST:
- 每个节点存储在单独的磁盘块中
- 从父节点遍历到子节点需要磁盘寻道
100万条记录的性能:
- 树高度:20个节点
- 磁盘寻道:20次
- HDD时间:20 × 10 ms = 200毫秒 ❌
- SSD时间:20 × 0.1 ms = 2毫秒 ⚠️
10亿条记录的性能:
- 树高度:30个节点
- HDD时间:30 × 10 ms = 300毫秒 ❌
- SSD时间:30 × 0.1 ms = 3毫秒 ⚠️
根本问题:BST扇出太低(每个节点只有2个子节点)。我们需要每个节点有更多子节点来降低树高度。
为什么不平衡树就行?
你可能会想:“只要保持树平衡就行!“红黑树和AVL树就是这样做的。
问题不仅仅是树高度——还有维护成本。平衡需要旋转节点和更新指针。在内存中,这很便宜(几次指针写入)。在磁盘上,代价高昂:
- 从磁盘读取节点(4KB块)
- 在内存中修改节点
- 将修改后的节点写回磁盘(4KB块)
- 更新父指针(更多磁盘I/O)
对于频繁插入和删除的树,持续的重新平衡会严重影响性能。
我们需要一个数据结构:
- ✅ 高扇出(每个节点有多个子节点) → 降低高度
- ✅ 不频繁重新平衡 → 降低I/O开销
这个数据结构就是B树。
什么是B树
B树是为磁盘访问优化的自平衡树。每个节点不是2个子节点(二叉树),而是数百或数千个子节点。
核心思想
每个B树节点适合一个磁盘块(4KB-16KB)。既然我们必须读取整个块,不如在其中打包尽可能多的键。
B树结构
一个B树节点存储:
- N个键(已排序)
- N+1个指针指向子节点
每个键作为分隔符:
- child[i] 中的键 < key[i]
- child[i+1] 中的键 >= key[i]
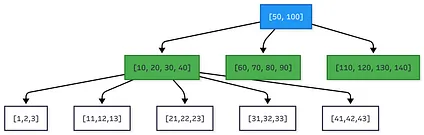
图2:扇出~100的B树。根节点有2个键和3个子节点。内部节点有4个键和5个子节点。叶节点包含实际数据。
B树层次结构
B树有三种节点类型:
| 节点类型 | 作用 | 存储内容 |
|---|---|---|
| 根节点 | 树的顶部 | 分隔键和指针 |
| 内部节点 | 中间层,引导搜索 | 分隔键和指针(无数据) |
| 叶节点 | 底层,包含实际数据 | 键值对 |
注意:这是B+树,最常见的变体。B+树只在叶子中存储数据,而B树也可以在内部节点中存储数据。每个主要数据库都使用B+树,但为了简单起见称之为”B树”。
高扇出的重要性
二叉树(扇出=2):
- 100万条记录 → 高度 = 20
- 10亿条记录 → 高度 = 30
B树(扇出=100):
- 100万条记录 → 高度 = 3(因为 100³ = 1,000,000)
- 10亿条记录 → 高度 = 5(因为 100⁵ = 10,000,000,000)
B树(扇出=1000):
- 100万条记录 → 高度 = 2(因为 1000² = 1,000,000)
- 10亿条记录 → 高度 = 3(因为 1000³ = 1,000,000,000)
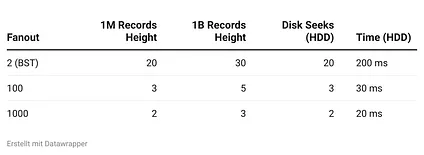
高扇出 = 更少的磁盘寻道 = 更快的查询。
💡 深入阅读:想了解为什么低扇出会扼杀性能以及详细的性能计算?查看扇出深入解析。
B树查找算法
在B树中查找键是从根到叶的遍历,在每个节点进行二分查找。
算法步骤
- 从根节点开始
- 在当前节点的键中进行二分查找,找到分隔键范围
- 跟随相应的子指针
- 重复直到到达叶节点
- 在叶子中找到键或得出结论键不存在
时间复杂度
- 树高度:O(log_fanout n)
- 每个节点的二分查找:O(log₂ fanout)
- 总计:O(log n)
查找示例
查找扇出100、100万条记录的B树中的键72:
步骤1:读取根节点(1次磁盘I/O)
  键:[50, 100, 150, ...]
  72在50和100之间
  跟随子指针2

步骤2:读取内部节点(1次磁盘I/O)
  键:[55, 60, 65, 70, 75, 80, ...]
  72在70和75之间
  跟随子指针5

步骤3:读取叶节点(1次磁盘I/O)
  键:[71, 72, 73, 74]
  找到!返回键72的值

总计:3次磁盘I/O操作 = HDD上30ms,SSD上0.3ms
Python实现:功能完整的B树
下面是一个简化但功能完整的Python B树实现:
from typing import List, Optional, Tuple
from dataclasses import dataclass, field

@dataclass
class BTreeNode:
    """
    B树节点,存储键和子指针

    属性:
        keys: 此节点中已排序的键列表
        children: 子节点指针列表 (len = len(keys) + 1)
        is_leaf: 如果是叶节点则为True(无子节点)

    不变量:
        - len(children) == len(keys) + 1 (对于内部节点)
        - 所有键已排序
        - children[i]中的键 < keys[i] < children[i+1]中的键
    """
    keys: List[int] = field(default_factory=list)
    children: List['BTreeNode'] = field(default_factory=list)
    is_leaf: bool = True

    def __repr__(self):
        return f"BTreeNode(keys={self.keys}, is_leaf={self.is_leaf})"

class BTree:
    """
    具有可配置阶数的B树实现

    属性:
        order: 每个节点的最大子节点数(扇出)
        root: 树的根节点

    性质:
        - 每个节点最多有 (order - 1) 个键
        - 每个非根节点至少有 (order // 2 - 1) 个键
        - 树高度为 O(log_order n)

    时间复杂度:
        - 搜索: O(log n)
        - 插入: O(log n)
        - 删除: O(log n)

    空间复杂度: O(n)
    """

    def __init__(self, order: int = 100):
        """
        初始化B树

        Args:
            order: 每个节点的最大子节点数(扇出)
                   更高的阶数 = 更少的层级但更大的节点
                   典型值:基于磁盘存储的100-1000
        """
        if order < 3:
            raise ValueError("阶数必须至少为3")

        self.order = order
        self.root = BTreeNode()

    def search(self, key: int) -> Optional[int]:
        """
        在B树中搜索键

        Args:
            key: 要搜索的键

        Returns:
            如果找到则返回键,否则返回None

        时间复杂度: O(log n),其中n是键的数量
        """
        return self._search_recursive(self.root, key)

    def _search_recursive(self, node: BTreeNode, key: int) -> Optional[int]:
        """
        从节点开始递归搜索键

        在每个节点内使用二分查找来找到正确的子节点
        """
        # 在此节点内进行二分查找
        i = self._binary_search(node.keys, key)

        # 找到精确匹配
        if i < len(node.keys) and node.keys[i] == key:
            return key

        # 到达叶子但未找到键
        if node.is_leaf:
            return None

        # 递归到适当的子节点
        # (在实际实现中,这将是磁盘I/O)
        return self._search_recursive(node.children[i], key)

    def _binary_search(self, keys: List[int], key: int) -> int:
        """
        二分查找以找到键的插入点

        Returns:
            索引i,其中 keys[i-1] < key <= keys[i]

        时间复杂度: O(log m),其中m是节点中的键数
        """
        left, right = 0, len(keys)
        while left < right:
            mid = (left + right) // 2
            if keys[mid] < key:
                left = mid + 1
            else:
                right = mid
        return left

    def insert(self, key: int):
        """
        在B树中插入键

        Args:
            key: 要插入的键

        时间复杂度: O(log n)

        算法:
            1. 找到适当的叶节点
            2. 将键插入叶子
            3. 如果叶子溢出(键太多),分裂它
            4. 如有必要,将分裂向上传播
        """
        root = self.root

        # 如果根节点满了,分裂它并创建新根
        if len(root.keys) >= self.order - 1:
            new_root = BTreeNode(is_leaf=False)
            new_root.children.append(self.root)
            self._split_child(new_root, 0)
            self.root = new_root

        self._insert_non_full(self.root, key)

    def _insert_non_full(self, node: BTreeNode, key: int):
        """
        将键插入未满的节点

        递归找到正确的叶子并插入
        """
        i = len(node.keys) - 1

        if node.is_leaf:
            # 插入到已排序位置
            node.keys.append(None)  # 腾出空间
            while i >= 0 and key < node.keys[i]:
                node.keys[i + 1] = node.keys[i]
                i -= 1
            node.keys[i + 1] = key
        else:
            # 找到要插入的子节点
            while i >= 0 and key < node.keys[i]:
                i -= 1
            i += 1

            # 如果子节点满了,分裂它
            if len(node.children[i].keys) >= self.order - 1:
                self._split_child(node, i)
                if key > node.keys[i]:
                    i += 1

            self._insert_non_full(node.children[i], key)

    def _split_child(self, parent: BTreeNode, child_index: int):
        """
        将满的子节点分裂为两个节点

        Args:
            parent: 包含满子节点的父节点
            child_index: parent.children中满子节点的索引

        算法:
            1. 创建新的兄弟节点
            2. 将一半的键从满子节点移动到兄弟节点
            3. 将中间键提升到父节点
            4. 更新父节点的子节点列表
        """
        full_child = parent.children[child_index]
        new_sibling = BTreeNode(is_leaf=full_child.is_leaf)

        mid = (self.order - 1) // 2

        # 将一半的键移动到新兄弟节点
        new_sibling.keys = full_child.keys[mid + 1:]
        full_child.keys = full_child.keys[:mid]

        # 如果不是叶子,移动一半的子节点
        if not full_child.is_leaf:
            new_sibling.children = full_child.children[mid + 1:]
            full_child.children = full_child.children[:mid + 1]

        # 将中间键提升到父节点
        promoted_key = full_child.keys[mid] if full_child.is_leaf else full_child.keys[mid]
        parent.keys.insert(child_index, promoted_key)
        parent.children.insert(child_index + 1, new_sibling)

    def print_tree(self, node: Optional[BTreeNode] = None, level: int = 0):
        """打印树结构用于调试"""
        if node is None:
            node = self.root

        print("  " * level + f"Level {level}: {node.keys}")
        if not node.is_leaf:
            for child in node.children:
                self.print_tree(child, level + 1)

# 示例使用和演示
if __name__ == "__main__":
    # 创建阶数为5的B树(每个节点最多4个键)
    btree = BTree(order=5)

    # 插入键
    keys = [10, 20, 5, 6, 12, 30, 7, 17, 3, 16, 21, 24, 25, 26, 27]
    print("插入键:", keys)
    for key in keys:
        btree.insert(key)

    print("\nB树结构:")
    btree.print_tree()

    # 搜索键
    print("\n搜索键:")
    for search_key in [6, 16, 21, 100]:
        result = btree.search(search_key)
        if result:
            print(f"  键 {search_key}: 找到")
        else:
            print(f"  键 {search_key}: 未找到")

    # 性能分析演示
    print("\n--- 性能分析 ---")
    print(f"树的阶数(扇出): {btree.order}")
    print(f"每个节点的最大键数: {btree.order - 1}")

    # 估算大数据集的树高度
    def estimate_height(num_records: int, fanout: int) -> int:
        """估算给定记录数和扇出的树高度"""
        import math
        return math.ceil(math.log(num_records, fanout))

    datasets = [
        ("1千", 1_000),
        ("100万", 1_000_000),
        ("10亿", 1_000_000_000),
    ]

    fanouts = [5, 100, 1000]

    print("\n估算的树高度(=磁盘寻道次数):")
    print(f"{'数据集':<15} {'扇出=5':<10} {'扇出=100':<12} {'扇出=1000':<12}")
    for name, size in datasets:
        heights = [estimate_height(size, f) for f in fanouts]
        print(f"{name:<15} {heights[0]:<10} {heights[1]:<12} {heights[2]:<12}")

    print("\nHDD上的磁盘访问时间(每次寻道10ms):")
    print(f"{'数据集':<15} {'扇出=5':<10} {'扇出=100':<12} {'扇出=1000':<12}")
    for name, size in datasets:
        times = [f"{estimate_height(size, f) * 10}ms" for f in fanouts]
        print(f"{name:<15} {times[0]:<10} {times[1]:<12} {times[2]:<12}")
输出示例
插入键: [10, 20, 5, 6, 12, 30, 7, 17, 3, 16, 21, 24, 25, 26, 27]

B树结构:
Level 0: [12, 20, 25]
  Level 1: [3, 5, 6, 7, 10]
  Level 1: [16, 17]
  Level 1: [21, 24]
  Level 1: [26, 27, 30]

搜索键:
  键 6: 找到
  键 16: 找到
  键 21: 找到
  键 100: 未找到

--- 性能分析 ---
树的阶数(扇出): 5
每个节点的最大键数: 4

估算的树高度(=磁盘寻道次数):
数据集           扇出=5     扇出=100     扇出=1000
1千             5          2            1
100万           9          3            2
10亿            13         5            3

HDD上的磁盘访问时间(每次寻道10ms):
数据集           扇出=5     扇出=100     扇出=1000
1千             50ms       20ms         10ms
100万           90ms       30ms         20ms
10亿            130ms      50ms         30ms
实现要点
✅ 为什么这个实现有效:
- 每个节点最多存储
order - 1个键 - 分裂操作维护B树不变量
- 节点内的二分查找减少比较次数
- 树高度保持对数级
B树节点分裂与合并
节点分裂
当向满的叶节点插入键时,节点必须分裂。
分裂算法:
- 找到满节点的中点
- 创建新的兄弟节点
- 将一半的键移动到新节点
- 将中间键提升到父节点
- 如果父节点满了,递归分裂它
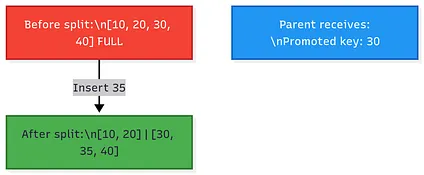
图3:插入期间的节点分裂。满节点在中点分裂,中间键(30)被提升到父节点。
当分裂传播到根时:
- 根被分裂为两个节点
- 创建新根,包含一个键(从旧根提升的键)
- 树高度增加1
这是B树中树高度增加的唯一方式。B树从叶子向上生长,而不是从根向下生长。
节点合并
当从节点删除键并且它变得太空(低于50%容量)时,它与兄弟节点合并。
合并算法:
- 将右兄弟的所有键复制到左兄弟
- 将父节点的分隔键降级到合并节点
- 移除右兄弟
- 如果父节点变得太空,递归合并它
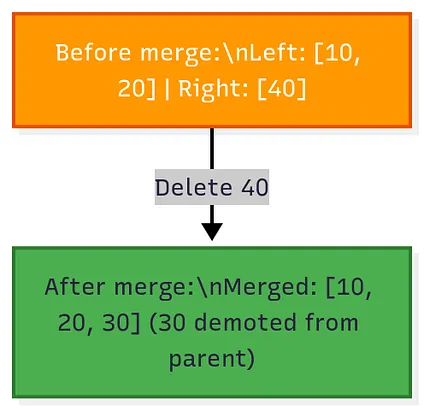
图4:删除期间的节点合并。当右节点变得太空时,它与左节点合并,从父节点拉取分隔键。
当合并传播到根时:
- 如果合并后根只有一个子节点,该子节点成为新根
- 树高度减少1
分裂和合并保持树的平衡。所有叶节点保持在相同深度,确保一致的查询性能。
B树性能特征
查找复杂度
时间复杂度:O(log n)
对于有n个键、扇出为f的树:
- 树高度:log_f(n)
- 每个节点的二分查找:log₂(f)
- 总比较次数:log_f(n) × log₂(f) = O(log n)
磁盘I/O:log_f(n) 次磁盘读取(每层一次)
插入复杂度
时间复杂度:O(log n)
- 查找插入点:O(log n)
- 插入叶子:O(f) 移动键
- 必要时分裂:O(f) 移动键
- 分裂向上传播:最坏情况 O(log n) 层
磁盘I/O:O(log n) 次磁盘读取 + O(log n) 次磁盘写入
删除复杂度
时间复杂度:O(log n)
- 查找键:O(log n)
- 从叶子删除:O(f) 移动键
- 必要时合并:O(f) 移动键
- 合并向上传播:最坏情况 O(log n) 层
磁盘I/O:O(log n) 次磁盘读取 + O(log n) 次磁盘写入
空间复杂度
空间:O(n)
每个键存储一次。内部节点增加开销(指针和分隔键),但这通常是数据大小的10-20%。
占用率:节点通常50-90%满。更高的扇出提高空间效率,因为指针开销比例变小。
真实世界的B树应用
每个主要数据库都使用B树(或B+树)作为索引。
MySQL InnoDB
InnoDB使用B+树用于:
- 主键索引(聚簇索引):在叶节点存储实际行数据
- 二级索引:在叶节点存储主键指针
InnoDB B树配置:
- 页面大小:16 KB(默认)
- 扇出:~100-200(取决于键大小)
- 100万行的树高度:3-4层
示例:
-- 创建带主键的表
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(100),
    email VARCHAR(100)
) ENGINE=InnoDB;

-- 主键自动创建聚簇B+树索引
-- 叶节点包含实际行数据
-- 树结构:id=1与name和email一起存储在叶子中

-- 在email上创建二级索引
CREATE INDEX idx_email ON users(email);

-- 二级索引是单独的B+树
-- 叶节点包含 email → id 映射
-- 要获取完整行:在idx_email中查找email → 获取id → 在主键中查找idInnoDB查询性能:
-- 快速:使用B树索引
SELECT * FROM users WHERE id = 12345;
-- 磁盘I/O:3-4次读取(树高度)

-- 慢:全表扫描
SELECT * FROM users WHERE name = 'Alice';
-- 磁盘I/O:10,000+次读取(扫描所有页面)

-- 快速:使用二级索引
SELECT * FROM users WHERE email = 'alice@example.com';
-- 磁盘I/O:6-8次读取(3-4次idx_email + 3-4次主键)
PostgreSQL
PostgreSQL使用B树作为默认索引类型。
PostgreSQL B树配置:
- 页面大小:8 KB(默认)
- 扇出:~50-100(取决于键大小)
- 支持多种索引类型(B-Tree、Hash、GiST、GIN、BRIN),但B树是默认值
示例:
-- 默认索引是B树
CREATE INDEX idx_user_id ON users(id);

-- 显式指定B树
CREATE INDEX idx_user_email ON users USING BTREE(email);

-- 查看索引结构
SELECT * FROM pg_indexes WHERE tablename = 'users';
SQLite
SQLite为表和索引都使用B树。
SQLite B树配置:
- 页面大小:4 KB(默认,可配置到64 KB)
- 扇出:~50-100
- 所有数据都存储在B树中(没有单独的堆存储)
有趣的事实:SQLite因历史原因将其B树实现称为”r-tree”,但实际上是B+树。
MongoDB WiredTiger
MongoDB的WiredTiger存储引擎为索引使用B树。
WiredTiger B树配置:
- 内部页面大小:4 KB(默认)
- 叶页面大小:32 KB(默认)
- 扇出:~100-200
- 支持前缀压缩以增加扇出
示例:
// MongoDB默认在_id上创建B树索引
db.users.insertOne({ _id: 1, name: "Alice", email: "alice@example.com" });

// 创建二级索引(B树)
db.users.createIndex({ email: 1 });

// 查询使用B树索引
db.users.find({ email: "alice@example.com" });
// 磁盘I/O:3-4次读取(树高度)

// Explain显示索引使用
db.users.find({ email: "alice@example.com" }).explain();
// 输出:"indexName": "email_1", "stage": "IXSCAN"
权衡与限制
B树并不完美。以下是它们遇到困难的情况:
1. 写放大
每次插入都可能触发一直到根的分裂。最坏情况:
- 插入1个键 → 分裂叶子 → 分裂父节点 → 分裂祖父节点 → 分裂根
- 一次逻辑写入变成4+次物理写入
示例:插入100万个键并频繁分裂:
- 逻辑写入:100万
- 物理写入(含分裂):200-300万
- 写放大:2-3倍
替代方案:LSM树(Log-Structured Merge Trees),用于RocksDB、Cassandra和LevelDB。LSM树在内存中批量写入,然后顺序刷新到磁盘,避免就地更新。
2. 非顺序键的范围查询
B树针对索引键的范围查询进行了优化,但在多列范围查询上表现不佳。
示例:
-- 快速:索引列的范围查询
SELECT * FROM orders WHERE order_date BETWEEN '2024-01-01' AND '2024-12-31';
-- B树顺序遍历叶节点(叶节点已链接)

-- 慢:非索引列的范围查询
SELECT * FROM orders WHERE total_amount BETWEEN 100 AND 200;
-- 必须扫描整个表(total_amount上没有索引)

-- 慢:多列范围查询
CREATE INDEX idx_date_amount ON orders(order_date, total_amount);
SELECT * FROM orders WHERE order_date > '2024-01-01' AND total_amount > 100;
-- B树可以使用order_date范围,但必须在内存中过滤total_amount替代方案:多维索引如R树(用于空间数据)或混合索引。
3. 缓存的内存开销
为避免磁盘I/O,数据库在内存中缓存频繁访问的B树节点。对于大型数据库:
- 10亿条记录
- 树高度:4层
- 内部节点:~100万
- 缓存大小:~16 GB(缓存所有内部节点)
经验法则:为B树缓存规划数据库大小的10-20%的RAM。
4. 随时间的碎片化
经过多次插入和删除后,B树节点可能只有50-60%满。这浪费空间并增加树高度。
解决方案:定期VACUUM(PostgreSQL)或OPTIMIZE TABLE(MySQL)来重建B树。
示例:
-- PostgreSQL:重建表和索引
VACUUM FULL users;

-- MySQL:优化表(重建B树)
OPTIMIZE TABLE users;
5. 并发挑战
B树在分裂和合并期间需要锁定。在高并发工作负载中,锁争用可能成为写入瓶颈。
解决方案:无锁B树(用于Microsoft SQL Server等现代数据库)或MVCC(多版本并发控制)。
何时不使用B树
B树对于基于磁盘的排序数据非常出色,但并非总是最优:
💡 深入阅读:想了解更多数据库索引结构(LSM树、哈希表、跳表、R树等)及其适用场景?查看数据库索引结构对比。
写密集型工作负载
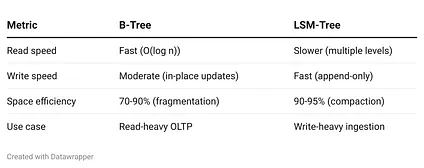
如果你每秒执行100,000次写入而很少读取,LSM树的性能优于B树。
对比:
示例:
- B树:MySQL、PostgreSQL、SQLite
- LSM树:RocksDB、Cassandra、LevelDB
内存数据库
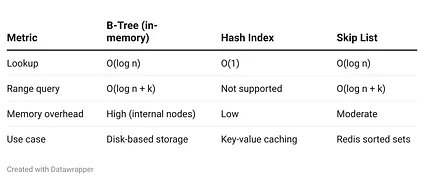
如果整个数据集适合RAM,B树增加了不必要的复杂性。哈希索引或跳表更简单、更快。
对比:
示例:
- 哈希索引:Memcached、Redis哈希
- 跳表:Redis有序集合
分析工作负载(OLAP)
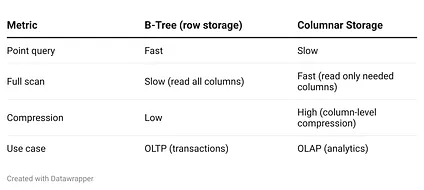
对于扫描数百万行的大型分析查询,列式存储(如Parquet、ORC)的性能优于B树。
对比:
示例:
- 行存储(B树):MySQL、PostgreSQL
- 列式存储:Parquet(Snowflake、BigQuery使用)、ORC(Hive使用)
总结:为什么B树胜出
经过50多年,B树仍然是主导的磁盘数据结构,因为它们:
✅ 最小化磁盘I/O:高扇出降低树高度 ✅ 自动平衡:分裂和合并保持所有叶子在相同深度 ✅ 支持范围查询:排序的键和叶级链接实现高效扫描 ✅ 适用于任何磁盘:针对HDD(顺序I/O)和SSD(块级访问)优化
核心洞察
B树匹配磁盘存储的约束。由于最小I/O单位是块,B树在每个块中打包尽可能多的数据。这个简单的想法——最大化扇出以最小化高度——使数据库变快。
使用指南
何时使用B树:
- 基于磁盘的存储(数据库索引)
- 频繁读取和适度写入
- 排序数据的范围查询
- 通用OLTP工作负载
何时考虑替代方案:
- 写密集型工作负载(LSM树)
- 内存数据(哈希索引、跳表)
- 分析查询(列式存储)
每次查询数据库并在毫秒内获得结果时,都要感谢B树。
参考资料
本文基于Alex Petrov的《Database Internals: A Deep Dive into How Distributed Data Systems Work》(O’Reilly,2019)第2章(“B-Tree基础”)。
论文
- Bayer, R., & McCreight, E. (1972). “Organization and Maintenance of Large Ordered Indexes.” Acta Informatica, 1(3), 173-189. https://doi.org/10.1007/BF00288683
- Comer, D. (1979). “The Ubiquitous B-Tree.” ACM Computing Surveys, 11(2), 121-137. https://doi.org/10.1145/356770.356776
- Graefe, G. (2011). “Modern B-Tree Techniques.” Foundations and Trends in Databases, 3(4), 203-402. https://doi.org/10.1561/1900000028
数据库文档
- MySQL Documentation: “InnoDB B-Tree Indexes”
- PostgreSQL Documentation: “B-Tree Indexes”
- SQLite Documentation: “B-Tree Module”
相关书籍
- Petrov, A. (2019). Database Internals: A Deep Dive into How Distributed Data Systems Work. O’Reilly Media. ISBN: 978-1492040347
- Knuth, D. E. (1998). The Art of Computer Programming, Volume 3: Sorting and Searching (2nd Ed.). Addison-Wesley. ISBN: 978-0201896855
- Graefe, G. (2011). Modern B-Tree Techniques. Now Publishers. ISBN: 978-1601984197
扩展阅读
本库相关文档
- B树深入解析:扇出与其他索引结构 - 详细解释扇出概念及数据库索引数据结构对比
- MySQL索引优化
- SQL Server索引设计
- 树形数据结构
讨论话题
- 你使用过哪些数据库系统?(MySQL、PostgreSQL、MongoDB?)
- 在生产环境中遇到过B树性能瓶颈吗?
- 哪些索引策略对你的工作负载效果很好?
- 对于写密集型工作负载,你比较过B树和LSM树吗?
- 有任何有趣的索引查询优化故事吗?